OlhoNaLei
Plataforma civic-tech sem fins lucrativos que torna a legislação federal compreensível.
- Papel
- Fundador e único engenheiro
- Período
- 2026 – Atual
Em números
- projetos de lei ingeridos
- 167 mil+
- análises escritas por IA
- 29 mil+
- busca vetorial mais rápida
- ~220×
- projetos históricos recuperados
- 8.300+
Visão geral
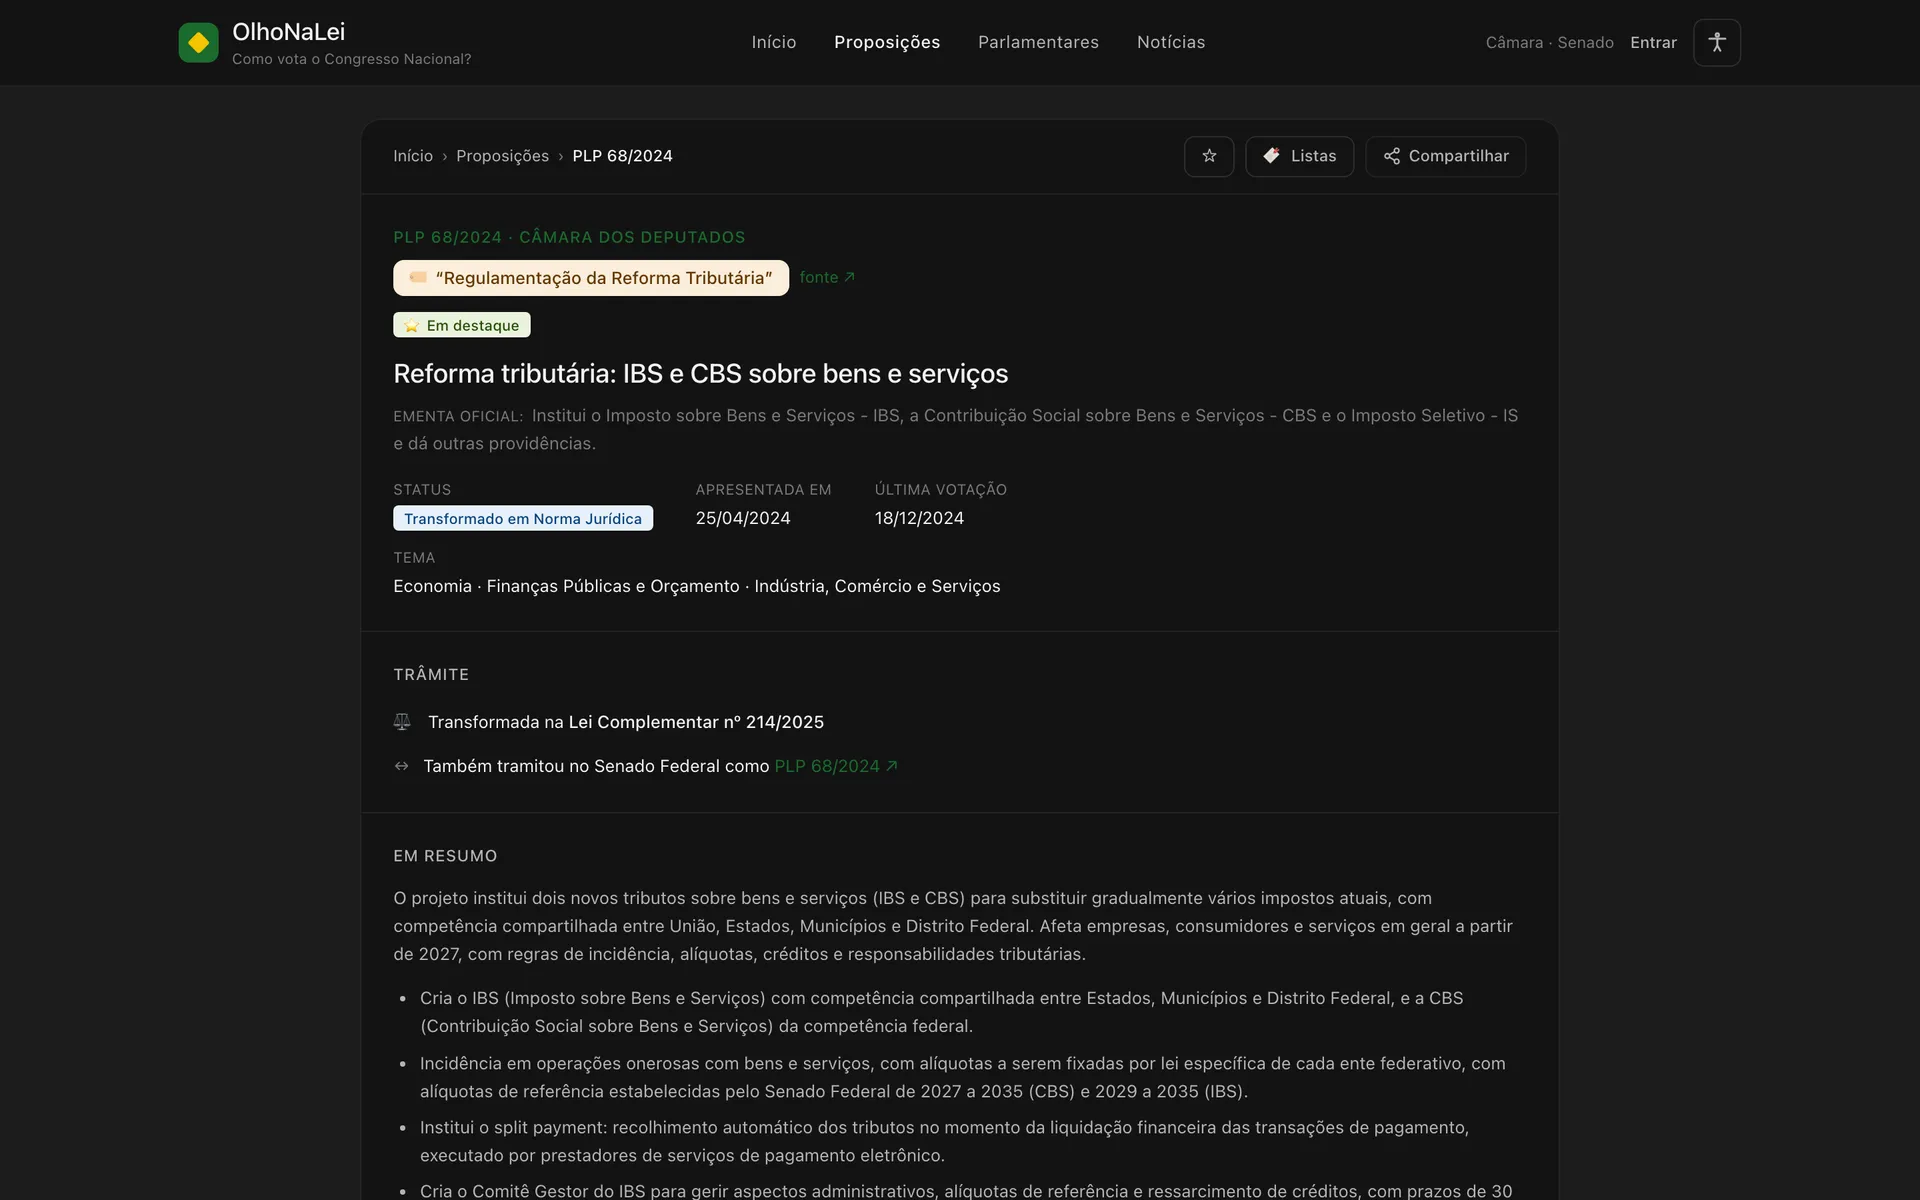
O OlhoNaLei reúne num só lugar o que acontece na Câmara dos Deputados e no Senado: proposições em tramitação, como terminou cada votação e como votou cada parlamentar, com resumos em linguagem simples feitos por IA. Os dados vêm dos portais oficiais de dados abertos das duas casas.
Projetei, construí e opero tudo sozinho, do pipeline de ingestão à interface. Está no ar, em modo de baixa manutenção.
Independente e sem fins lucrativos: não é um serviço do governo e não tem vínculo com partido ou órgão público.
Como os dados fluem
Fontes
API da Câmara
API do Senado
Ingestão
Pipeline em Python
noturno · resumível · idempotente
Staging
Firestore
só escrita
Banco
PostgreSQL + pgvector
Supabase, São Paulo
Análise por IA
Claude Message Batches
teto mensal de gastos
Entrega
Site Next.js + admin
Edge Function de busca
Redes + newsletter
revisão humana
O que construí
- 01Projetei, construí e opero a plataforma inteira sozinho: pipeline de dados, API REST, análise por IA, frontend, infraestrutura e crescimento.
- 02Ingestão noturna em Python, resumível e idempotente, das APIs de dados abertos da Câmara e do Senado (staging no Firestore → PostgreSQL), unificando dois formatos JSON diferentes num só modelo relacional.
- 03Busca híbrida (full-text do PostgreSQL com dicionário em português + pgvector), reconstruída com quantização binária e rerank: de ~1.850 ms para ~8 ms.
- 04Pipeline de análise com Claude: mais de 29 mil resumos em linguagem simples, avaliações de impacto fiscal e detecção de “jabutis”, com teto mensal de gastos de LLM e a Message Batches API.
- 05Site público e console administrativo interno em Next.js 15 / React 19 / TypeScript / Tailwind (Server Components, ISR, imagens OG dinâmicas).
- 06Distribuição automatizada para Instagram, Facebook, Bluesky e newsletter, com revisão humana no fluxo.
- 07Diagnostiquei e eliminei um estouro de custo serverless de ~39 mil invocações.
- 08Segurança: RLS, PostgREST e conformidade com a LGPD.
Antes e depois
- Antes
- ~1.850 ms
- Depois
- ~8 ms (~220×)
- Antes
- 1,3 GB
- Depois
- 69 MB
- Antes
- ~1,49 s
- Depois
- ~0,55 s
Estudos de caso
Busca vetorial 220× mais rápida num Postgres pequeno
Problema
A busca híbrida (full-text + pgvector) sobre mais de 167 mil projetos de lei levava ~1.850 ms por consulta, e o índice HNSW de 1,3 GB não cabia com folga na memória de uma instância Postgres econômica.
O que fiz
- Perfilei o caminho da consulta antes de mudar qualquer coisa.
- Reconstruí o índice HNSW com quantização binária: vetores guardados como bits para uma primeira passada rápida, e os melhores candidatos reordenados com os vetores de precisão total, para manter a qualidade dos resultados.
- Medi antes e depois, com benchmarks.
- Depois medi o resto do tempo de ponta a ponta: a API rodava nos EUA enquanto o banco e o site estavam em São Paulo, então cada busca cruzava a linha do Equador três vezes (184 ms por trecho, para 18 ms de trabalho real no Postgres).
- Levei a busca para uma Edge Function do Supabase na região do banco, com embeddings de consulta em cache, rollback de uma variável para o caminho antigo e um fallback lexical explícito (busca_degradada: true), para que a degradação silenciosa apareça.
Resultado
Índice de 1,3 GB para 69 MB. Busca no banco de ~1.850 ms para ~8 ms (~220×). Busca de ponta a ponta em produção de ~1,49 s para ~0,55 s.
Lição
Performance medida, não achada.
IA com custo sob controle, em escala
Problema
Escrever análises úteis, em linguagem simples, para dezenas de milhares de projetos de lei sem uma conta de LLM em aberto.
O que fiz
- Um pipeline com Claude na Message Batches API, que é mais barata e assíncrona.
- Cotas mensais de orçamento aplicadas no código. O backfill é limitado por orçamento e resumível: para no teto e continua no mês seguinte sem perder trabalho.
- Cada análise traz um resumo em linguagem simples, o impacto fiscal e possíveis “jabutis”, os dispositivos estranhos ao tema enfiados num projeto. Os projetos marcados ganham um selo no site.
- As publicações no Instagram, Facebook, Bluesky e na newsletter passam por revisão humana.
Resultado
Mais de 29 mil análises, com gasto previsível. À parte, encontrei e eliminei um estouro de custo serverless de ~39 mil invocações.
Lição
Custo também é funcionalidade.
Duas APIs do governo, um só modelo de dados
Problema
A Câmara e o Senado publicam a legislação em duas APIs JSON planas e bem diferentes entre si.
O que fiz
- Um pipeline noturno em Python, resumível, com checkpoints e idempotente: retentativas nunca duplicam nem perdem registros.
- Os dados brutos ficam em staging no Firestore (só escrita) e depois são normalizados num único modelo relacional em PostgreSQL: projetos, autores, votações e parlamentares.
- O produto nunca chama uma API do governo na hora da requisição; tudo é servido a partir do PostgreSQL.
- Logs estruturados do começo ao fim.
Resultado
Mais de 167 mil projetos de lei num só modelo, e mais de 8.300 projetos históricos que faltavam recuperados por um backfill limitado por orçamento.
Decisões de arquitetura
ADR 01
Nenhuma chamada às APIs do governo na hora da requisição: todos os dados são ingeridos antes e servidos do PostgreSQL.
ADR 02
O Firestore é uma camada de staging só de escrita; a API do produto lê apenas do PostgreSQL.
ADR 03
Busca full-text do PostgreSQL com o dicionário em português.
ADR 04
A busca semântica roda numa Edge Function do Supabase em São Paulo (sa-east-1), ao lado do banco.
Stack
- Python
- FastAPI
- Next.js 15
- React 19
- TypeScript
- Tailwind CSS
- PostgreSQL
- pgvector
- Supabase
- Deno Edge Functions
- Firestore
- Voyage embeddings
- Claude Message Batches
- Railway
- Vercel
- GitHub Actions
- Sentry
Quer os detalhes por trás disso?